AI 写的代码让 AI 查,这不是套娃
老张第一次意识到 review 这件事出了问题,是因为一次"差点漏掉"。
那天,团队提交了一个改动。那是一次团队已经习以为常的迭代——业务改动不算复杂,但 diff 铺开到了几十个文件、上千行。按惯例,老张要 review。
他打开 diff,往下翻。代码本身写得规整,变量命名清晰,该有的注释都有。老张看了半小时,觉得没什么问题,准备点 Approve。
临点之前,他习惯性地又扫了一眼其中一个文件。就这一眼,他发现了一个问题——某个空状态分支没有挂载确认弹窗,用户点删除按钮不会有任何反馈。
这是个真实会出问题的回归。用户在空列表页点删除,按钮像是失灵了一样,没反应。
老张停了一下:他已经看了半小时,还是差点漏掉。不是因为这个 bug 本身有多严重——它不算大。让他发凉的是:他刚才看了半小时,差点就漏掉了。 如果他最后那一眼没扫到,如果那天他稍微累一点、稍微急一点,这个 bug 就这么过了。
那天晚上,老张算了一笔账。
那次 diff,新增加修改大约上千行。一个工程师认真 review 代码——不是扫一眼,是真正读懂每一处变更——平均速度大概每分钟 10 行左右。上千行,就是一个多小时。
而这,是每一次代码合入都要发生的事。如果团队每天有几次合入,光 review 就要吃掉一个工程师大半天的时间。
老张突然明白了一个他之前不愿意承认的事实:人 review 不过来,不是因为人不够聪明,是因为信息密度太高。
一个让老张犹豫的方案
团队里有个工程师提了个建议:"要不,让阿行先 review 一遍?"
老张的第一反应是抗拒。让 AI 来 review AI 辅助写的代码?这不是套娃吗?而且,AI review 靠谱吗?万一它漏了问题,人因为"已经 review 过了"反而放松警惕,那不是更危险?
但他想了想自己刚才差点漏掉的那个 bug,又觉得——现状也没好到哪去。 人 review 走过场,比 AI review 不靠谱,起码 AI 不会"看到一半开始走神"。
他决定试一次。
第一次尝试:失败
第一次,他们用了一个最朴素的方案——把整个 diff 丢给阿行,让它"找出所有问题"。
结果让老张哭笑不得。
阿行确实找出了问题——找出了十几个问题。但其中大半是这种风格:"这里的命名可以更清晰""这段逻辑可能影响性能""建议补充注释"……过度敏感,什么都想说。
而那个真正重要的回归(空状态分支没挂弹窗),被淹没在一堆"可能""建议""或许"里面。老张拿到这份报告,反而更累了——他得从十几个"问题"里,自己挑出哪个是真问题。
这次失败让老张想明白了一件事:问题不在 AI 评得不准,而在它没有区分"确定的问题"和"可能的疑点",也没有告诉人"哪些我看过了、判断没问题"。 AI 试图证明自己"认真工作了",结果反而制造了噪音。
转折:换一种做法
老张不死心。有天晚上,他和 AI 聊起这个困境——"让 AI review 代码,怎么才能不乱报?"AI 给他推荐了一篇文章:Cloudflare 工程团队公开的 AI code review 实践。
老张点进去看了,发现这不是小打小闹。Cloudflare 的数据显示,他们在 30 天内用 AI review 了 48,000 多个代码合入,覆盖 5,000 多个仓库,而工程师只在 0.6% 的情况下需要强制放行(他们管这叫 break glass)。这个数字让老张坐直了——如果一家几千人的工程团队能用 AI 承担代码评审的第一轮信号筛选,说明这条路本身是走得通的。当然,Cloudflare 审的是普通 MR,不是专门审“AI 写的代码”——但老张觉得,方法是可以借鉴的。
更关键的是 Cloudflare 的方法。他们不是"一个 AI 找所有问题",而是让多个专门的 reviewer 分查安全、性能、代码质量等领域,再由一个协调器统一去重、改判、过滤掉那些不靠谱的推测。中位 review 时长只有 3 分多钟,平均成本约 1 美元。
老张没照搬 Cloudflare 的复杂架构——他没有 5,000 个仓库要管。但他从 Cloudflare 的方案里只借了两条原则:压低噪音、结构化严重度。 至于 Cloudflare 的多 reviewer 加协调器架构,他没有照搬——团队没那么大。他的做法更轻量:让同一个阿行输出三份分开的报告。这不具备多 reviewer 的独立性,但对他的团队规模来说够用了。
但在正式用之前,老张先做了一件事:拉了几份历史 MR,让阿行用新规矩跑一遍,然后自己对照看——它的判断准不准?噪音有没有降下来?试了几轮,发现确实比之前"一股脑列十几个问题"好多了,才正式定下来。
他给阿行的 review 任务定了三条新规矩:
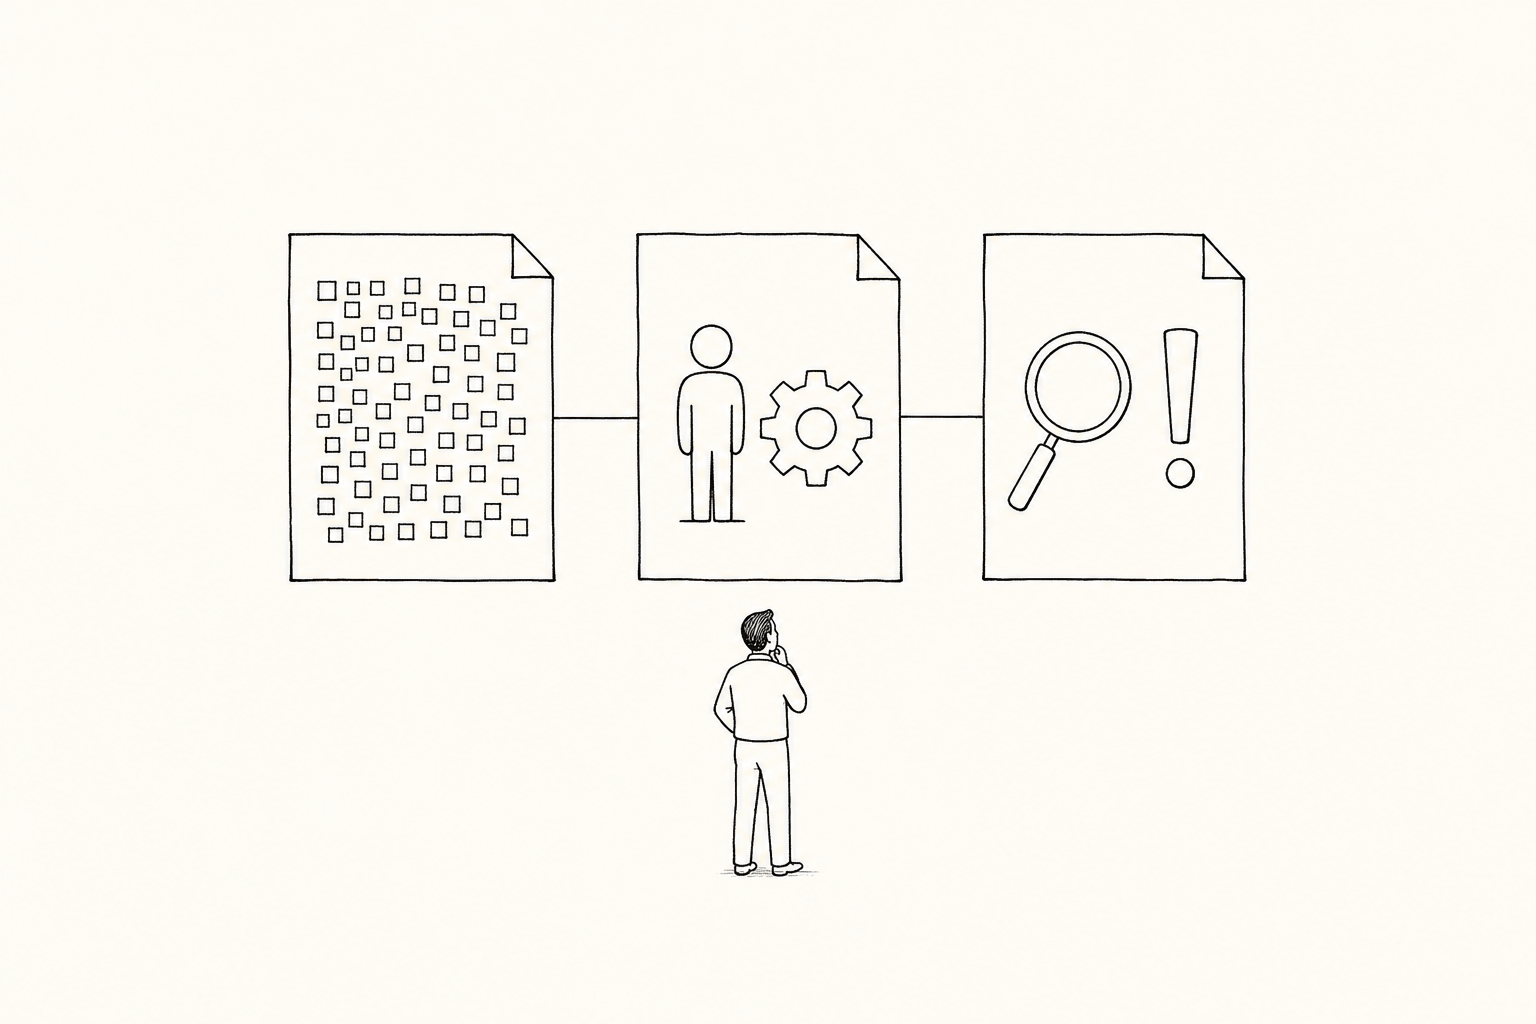
第一,分三份报告。 不要把所有东西混在一起。第一份只写"改了什么"(事实),第二份只写"对用户有什么影响"(影响),第三份才写"哪里有问题、问题多严重"(判断)。事实、影响、判断分开,老张核对起来更方便——他可以拿判断层的结论去对照事实层的代码。
第二,必须分级。 找到的问题不能一股脑全列出来,要分三档:🔴 拦截(必须修才能上线)、🟠 强烈建议(最好修,但不拦)、🟡 优化(有空再说)。老张原则上只看 🔴 和 🟠,🟡 可以批量延后。
第三,必须写"我看过但没问题的"。 这一条最关键。老张要求阿行在报告里专门留一节,写明"以下这些变更我看过了,判断为合理"。这不是说它写了就一定对——而是它暴露了 review 的覆盖范围,方便老张抽查:"你说这部分没问题,我的确扫一眼确认了。"真正控制乱报的,是另一条规矩:每一条 🔴 和 🟠 都必须附上可核对的代码证据(文件、行号、代码片段),涉及运行时行为的还要给出触发条件或失败测试。推测性的"可能有问题"不列入正式 finding。
一个月后:老张的态度变了
新规矩跑了一个月。老张的态度,从"试试看"变成了"回不去了"。
最直观的变化:老张每天真正需要认真看的,通常只有一两个问题。 绝大多数合入,🔴 是零;🟠 偶尔有一两条。那些 🟡 优化项,攒到周末一起批量处理。
而那一两个 🔴 或 🟠,每一条都精确到文件名和行号,附带"为什么是问题、用户会受什么影响、建议怎么修"。老张不用再从上千行 diff 里捞问题——问题已经被捞好了,他只需要做最后的判断。
那个"空状态分支没挂弹窗"的回归,如果用新规矩跑,会直接出现在 🟠 里,位置精确到行号,后果写清楚,建议也给好。老张不用靠"最后那一眼"碰运气。
更让老张意外的是——核对起来反而更方便了。 三份报告虽然都来自同一个阿行,但分开后,老张可以拿判断层的结论去对照事实层的代码:如果 review 报告说某处有回归,老张可以立刻翻到"事实报告"看那处的实际代码、翻到"影响报告"看对用户的影响——三者对得上,他才拍板。比他一个人凭记忆扫 diff 稳得多。
不过,这三份报告解决的是信息组织问题,并不等于三次独立审查。它们来自同一个 Agent,可能共享同一种遗漏和偏差;高风险改动仍需要独立测试、领域负责人复核,必要时还应先拆分过大的 MR。
但老张没有完全放心
老张承认这套做法好用。但他心里还压着一个问题,一个他一直没想清楚的问题。
阿行现在能 review 代码了。它能创建工单了。它能给人发消息了。它甚至能自己判断"这个工单该转给谁"。
某天早上,老张打开电脑,看到阿行凌晨发来的一条消息——它处理了一批卡住的工单,其中一条它判断不了,标注了"需要人工关注",并写了原因。
老张看完,处理得没毛病。但他盯着那条消息,突然冒出一个念头:
"等等。它刚才自己处理了工单。它自己决定把一条转给了产品经理。——这些事,谁允许它做的?"
老张意识到自己面对的是一个全新的、而且比 review 难得多的问题。
当一个 AI 既能写代码、又能 review、还能创建工单、给人发消息、自己决定把工单转给谁——这套流程的主导权,到底在谁手里?
这是第 4 篇的故事。
一句话结论
让 AI review AI 的代码产出,不是套娃,是把上千行 diff 压缩成"几个需要人判断的头部问题"——靠三份分开的报告和严格分级,让人的 review 从"看不过来"变成"只做最后拍板"。
参考来源
- Cloudflare:Orchestrating AI Code Review at scale — 48,095 个 MR、5,169 个仓库、0.6% break glass、中位 3 分 39 秒、平均成本 1.19 美元;数据窗口为 2026-03-10 至 04-09。